데이터 분석 · 머신러닝 · 최적화 · ML, Data
기후변화 대응 작물 수확량 예측 · 최적 재배치
미국 2,600개 카운티 35년 기후·토양 데이터로 작물 수확량을 예측하고, +2℃ 온난화 시 어느 카운티에 무엇을 심어야 손실을 최소화하는지 메타휴리스틱으로 최적화한 Purdue 해외 연구 프로그램 팀 프로젝트
프로그램 개요
2026 빅데이터 해외 연구 프로그램으로 미국 Purdue University에서 4주간 머신러닝과 최적화 두 과목을 수강하고, 두 과목을 결합한 팀 프로젝트를 수행했습니다.
- 머신러닝: 데이터 정제·파이프라인, 회귀·분류, 의사결정나무·랜덤포레스트, 신경망·CNN·RNN/LSTM
- 최적화: 선형·정수계획법, 지역 탐색, Simulated Annealing, Tabu Search, 유전 알고리즘, PSO, ACO, 메타휴리스틱 성능 평가
문제
미국은 세계 최대 곡물 수출국이라 생산이 흔들리면 세계 식량 가격이 흔들립니다. 기온이 1℃ 오르면 주요 작물 수확량이 16~20% 감소한다는 연구가 있지만, 대부분의 연구는 “얼마나 줄어드는가”라는 예측에서 멈춥니다. 의사결정자에게 필요한 것은 예측이 아니라 처방입니다.
“수확량이 얼마나 떨어질까”가 아니라 “제한된 농지를 어떻게 재배치해야 할까”에 답하는 것이 목표였습니다.
데이터
- ACDC 기후 데이터셋: 미국 2,644개 카운티, 1981~2015년, 70,721건
- 수확량(옥수수·대두·밀), 4~10월 온도 노출 분포(1℃ 구간별 노출일수 121개), 강수량, 토양 물성 11종, 농지 면적을 카운티-연도 키로 병합
- 결측치는 삭제 대신 물리 제약으로 복원 (온도 구간 결측 = 184일 − 나머지 합, silt = 100 − sand − clay)
1단계: 수확량 예측 (머신러닝)
핵심 선택: 평균 기온이 아니라 온도 노출 분포 전체를 사용
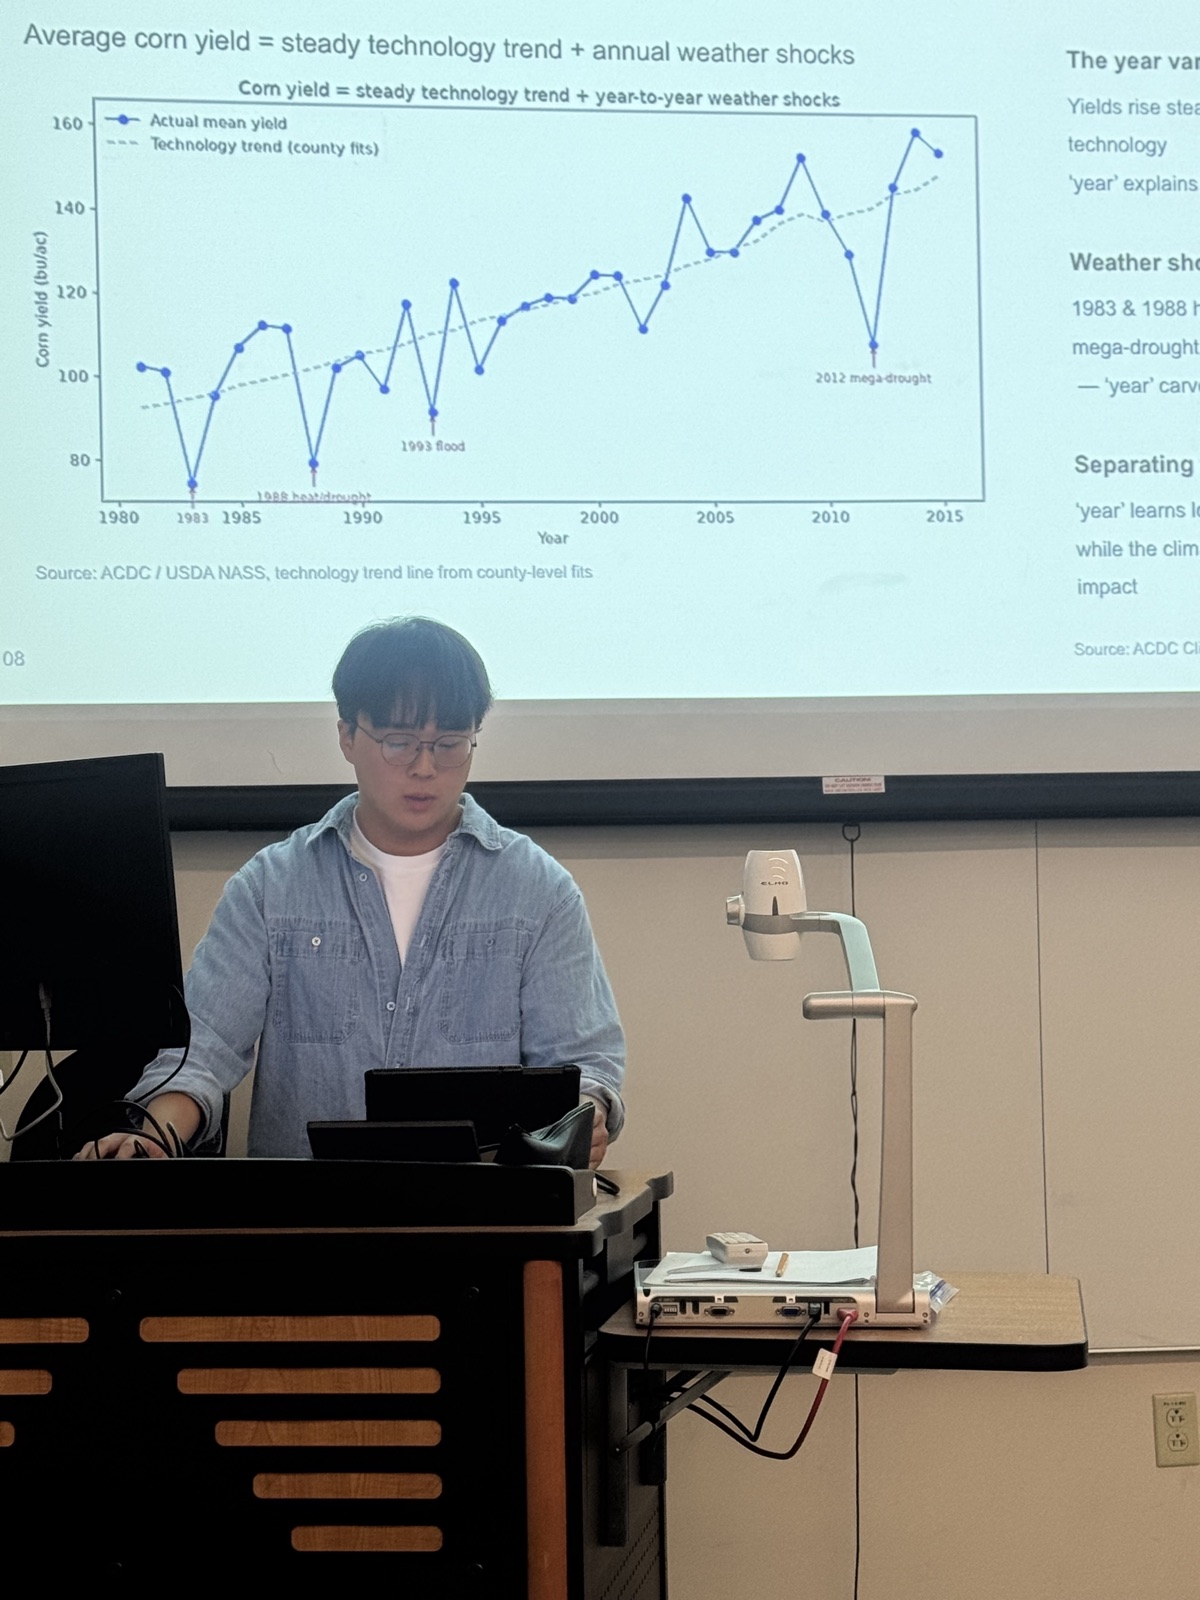
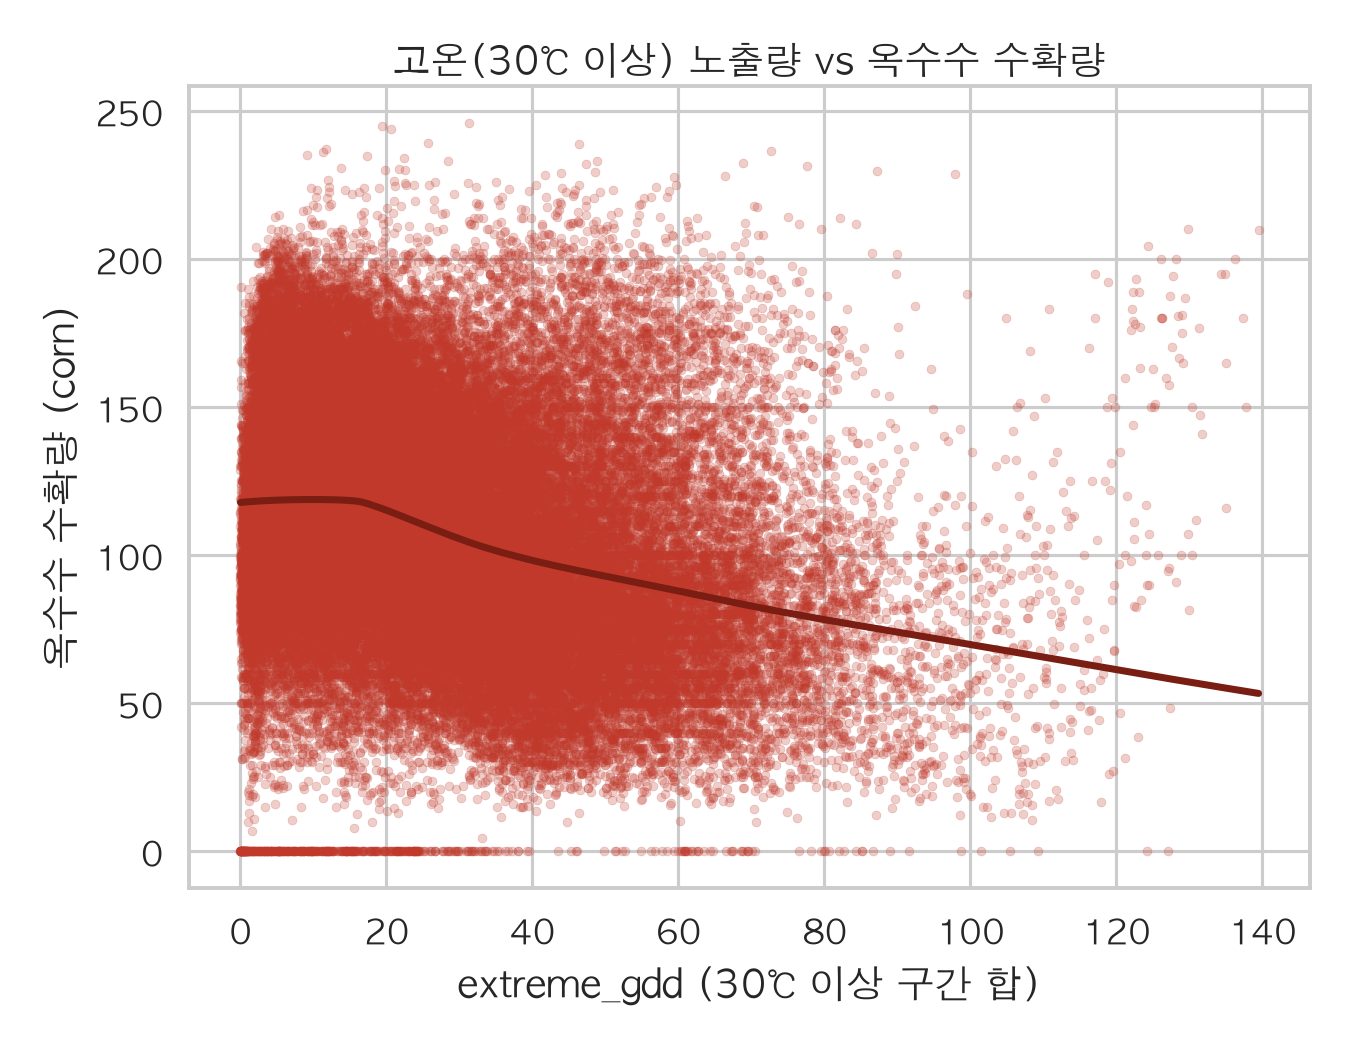
평균 기온이 거의 같은 두 카운티(0.012℃ 차이)도 29℃ 초과 노출일수가 6.1배 다르면 수확량이 58 bu/ac 벌어졌습니다. 그래서 평균 대신 온도 구간별 노출일수 분포를 피처로 썼습니다.
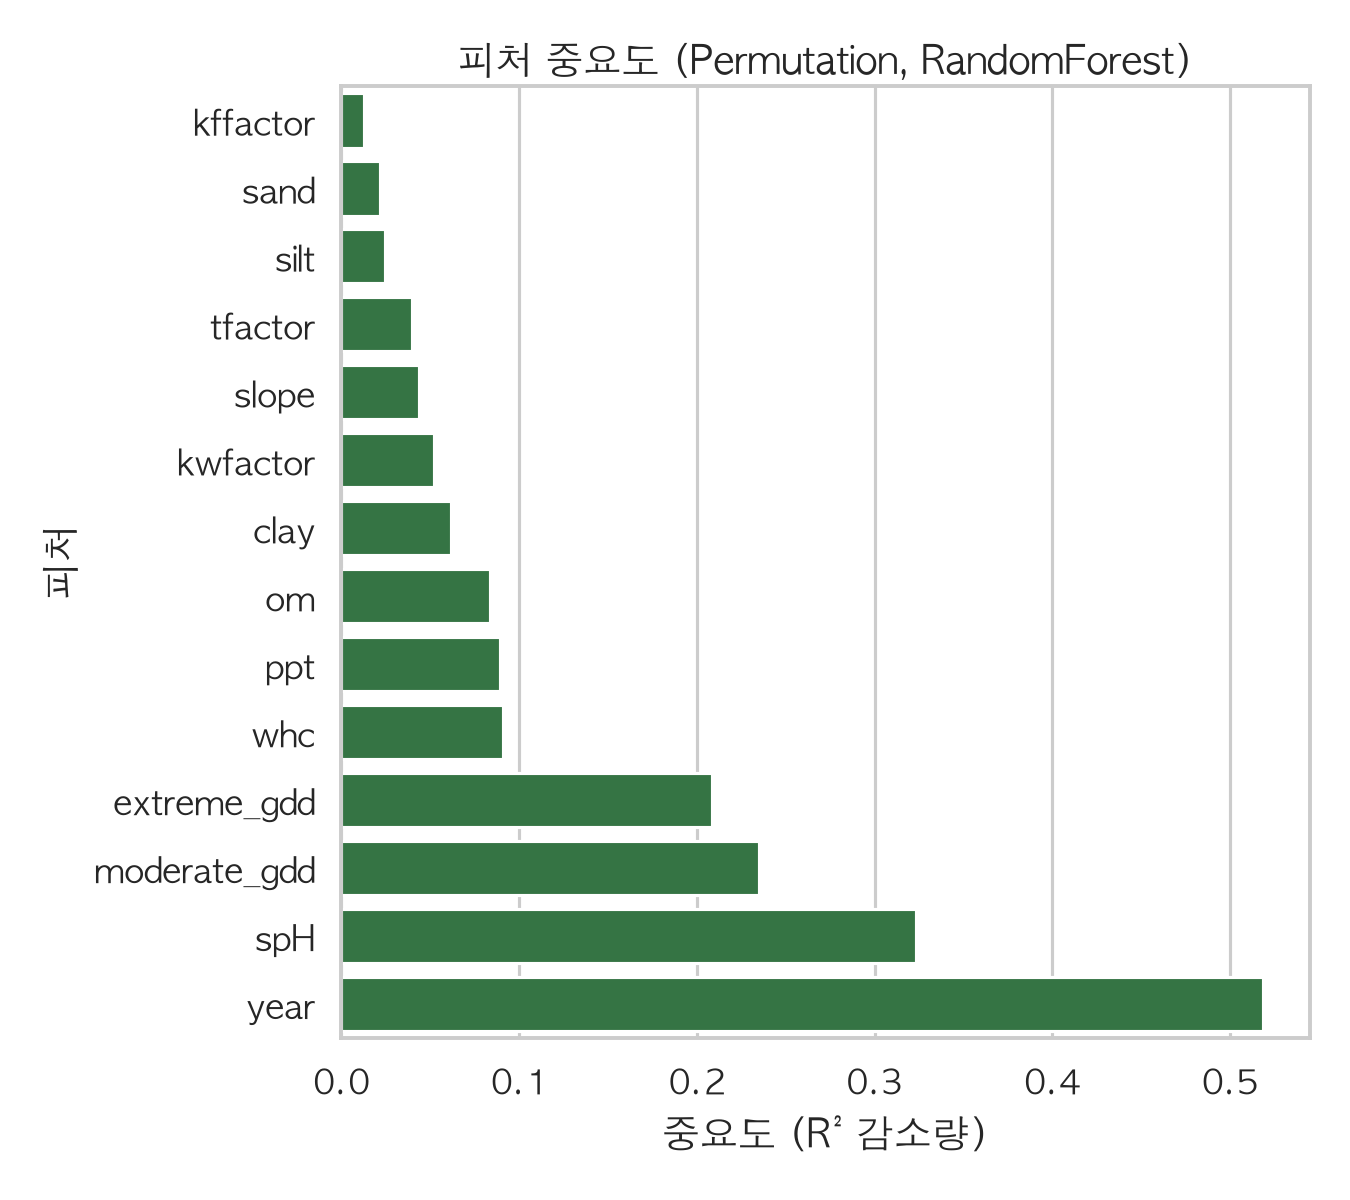
- EDA로 29℃ 고온 임계 신호, 인접 온도 구간 간 다중공선성(r=0.94), 토양 변수 간 높은 상관(sand↔silt −0.90)을 확인하고 두 가지 피처 전략(도메인 압축형 · 원자료+정규화형)을 설계
- 선형·트리·부스팅 9개 모델을 카운티 그룹 교차검증(GroupKFold)으로 비교해 공간 누수 차단. LightGBM이 옥수수 R² 0.73, 대두 0.81로 최고 (선형 모델은 0.44)
- 예측용 모델과 해석용 모델을 분리. 카운티·연도 고정효과 모델로 “온화한 하루가 29℃ 초과 하루로 바뀌면 옥수수 −1.67 bu/ac (t≈−60)” 추정
- 작물별 고온 민감도: 옥수수 −1.67 > 대두 −0.39 > 밀 −0.17. 이 차이가 재배치의 근거
+2℃ 시나리오 생성
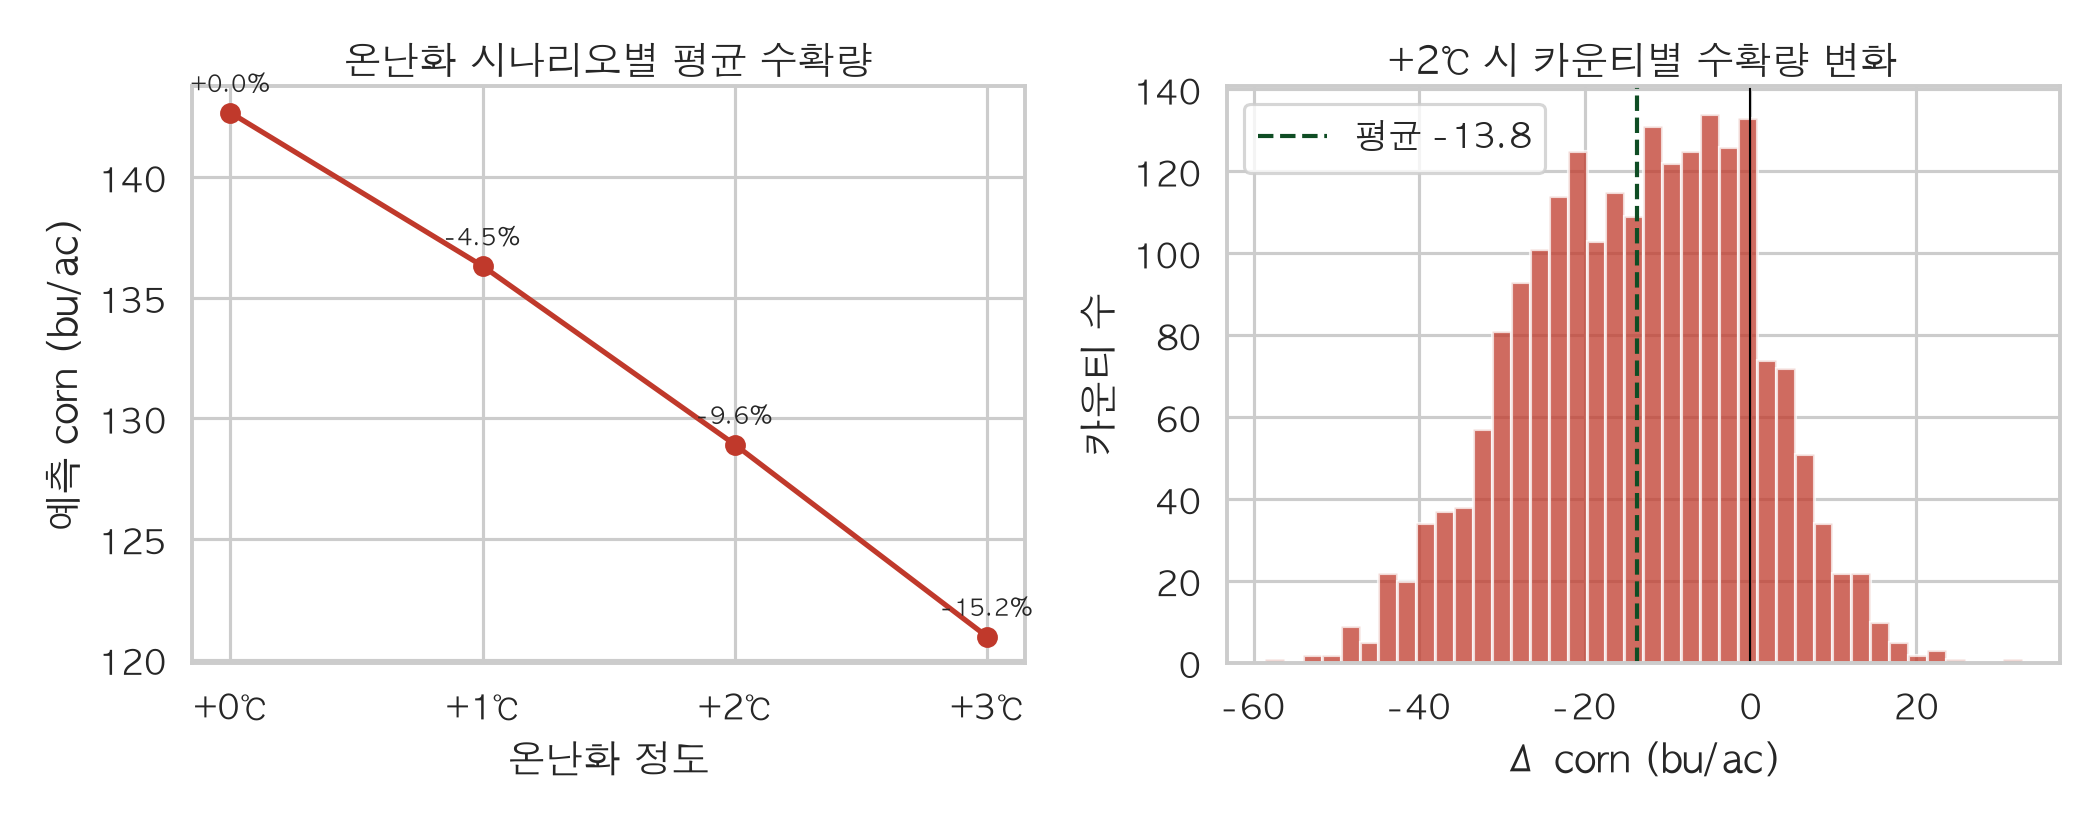
경험적 추세 외삽 대신 각 카운티의 최근 10년 기후 평년의 온도 분포를 +2℃ 평행이동하고(총 노출일수 184일 보존), 트리 모델의 외삽을 막기 위해 연도를 2015로 고정해 순수 기후 효과만 분리했습니다. 무조정 시 전국 수확량 약 −9%, 카운티의 79%가 손해를 보며 피해는 남부에 집중됐습니다.
2단계: 최적 작물 배치 (최적화)
목적함수: 총 이익 마진 최대화 = Σ(면적 × (가격 × 예측 수확량 − 비용)) − λ × 전환 비용
- 수확량을 목적계수로 두면 옥수수가 모든 카운티에서 이겨 해가 퇴화함을 실증하고, USDA ERS 실측 가격·변동비 기반 순이익($/ac)으로 단위화
- 2,056개 카운티마다 옥수수·대두·밀 중 하나를 선택. 제약: 농지 고정, 옥수수 총생산 하한
- GA · SA · TS 세 메타휴리스틱을 구현해 동일 예산에서 비교. 분리 가능한 문제에서는 셋 다 정확해에 도달하고 배분이 100% 일치. 2¹⁸ 완전탐색으로 분리가능성 주장을 반증 가능한 방식으로 검증
- λ를 0~400으로 바꿔 트레이드오프 곡선을 그리고 무릎점 λ=42를 찾음. 격자를 촘촘히 해도 무릎이 유지됨
결과
| 방법 | 재배치 면적 | 온난화 손실 회복 |
|---|---|---|
| Greedy (전환 비용 무시) | 30% | 23% |
| 메타휴리스틱 (λ=42) | 8% (222개 카운티) | 17% |
- Greedy 대비 1/3의 면적으로 70%의 회복 효과
- 최적 배치: 남부 고온 지역이 밀로 전환. 옥수수 재배 카운티 769 → 621. 알고리즘에 고온 내성 순위를 알려주지 않았는데 이익만 최대화해서 같은 결론에 도달
- 가격 ±30% 민감도 분석에서도 “남부 = 밀” 패턴 유지. “시장이 면적을 정하고, 기후가 위치를 정한다”
- 옥수수 최소 생산 제약을 걸면 카운티가 서로 묶여 문제가 NP-hard(다중선택 배낭)가 되고, 100% 유지 시 회복률이 14%로 하락. 식량안보와 기후 적응의 트레이드오프를 정량화
내가 맡은 부분
( 확인 필요: 아래는 남아 있는 코드와 보고서를 근거로 정리한 초안입니다. 실제 담당과 다르면 고쳐 주세요. )
- 5종 원자료 병합·결측 복원·피처 엔지니어링 및 EDA (온도·토양 상관분석 보고서 작성)
- 옥수수 수확량 예측 모델 비교 (선형회귀 · 랜덤포레스트 · 그래디언트 부스팅, 연도 분할 vs 무작위 분할 검증)
- +ΔT 온난화 시나리오 생성 스크립트 구현 (온도 분포 이동, 외삽 위험 카운티 표시)
- 시계열 접근 타당성 진단 (추세·지역 효과 제거 후 잔차 자기상관 검정)
- ( 빈칸: 최적화 파트에서 맡은 부분 )
- ( 빈칸: 발표에서 맡은 파트 )
배운 점
- 예측과 처방은 다르다. 머신러닝은 “얼마나”를 답하고 최적화는 “어떻게”를 답한다. 예측 모델을 목적함수 안에 넣어야 의사결정에 쓸 수 있다는 것을 프로젝트 전체 구조로 체득
- 검증 설계가 결과를 좌우한다. 같은 카운티의 다른 연도가 학습·테스트에 섞이면 R²가 0.83으로 과대평가되고, 그룹 교차검증을 하면 0.73이 된다. 정직한 검증이 무엇인지 배움
- 메타휴리스틱은 문제 구조를 알고 써야 한다. 분리 가능한 문제에서 SA·TS가 빨랐던 건 알고리즘이 좋아서가 아니라 문제 구조를 활용했기 때문. 제약이 카운티를 묶는 순간 비로소 메타휴리스틱이 필요해짐
- 단일 실행 결과를 믿지 않기. 여러 번 독립 실행 후 Shapiro-Wilk, Mann-Whitney U 등 통계 검정으로 알고리즘을 비교하는 습관
- 이 경험은 Keeping의 수요예측·발주 최적화에 그대로 이어짐. “재고 부족 예측 → 발주안 생성”이 “수확량 예측 → 작물 배치”와 같은 구조
발표
- 07.16 ML 발표: Climate-Driven Crop Yield Prediction
- 07.17 최적화 발표: Metaheuristics for Optimizing Crop Reallocation Under Climate Change
사진